Para contextualizar os sistemas Supervisory Control and Data Acquisition (SCADA), primeiro pensemos em um problema-exemplo recorrente como ilustração.
Considere um serviço autônomo de água e esgoto de uma cidade de 120 mil habitantes.
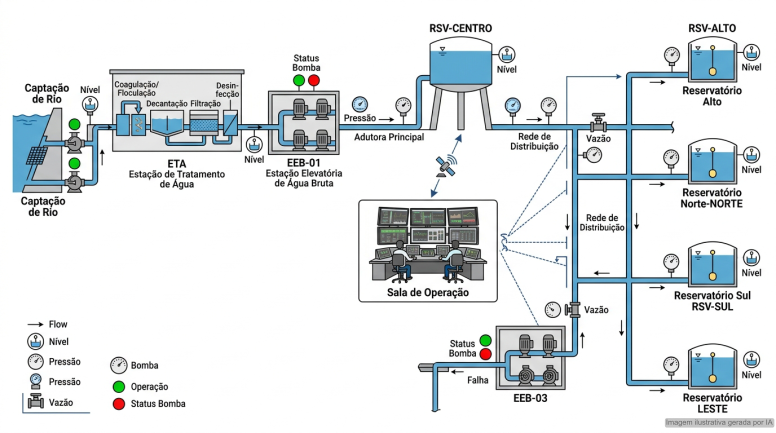
Este serviço opera uma captação às margens do rio, uma estação de tratamento, três estações elevatórias de bombeamento e cinco reservatórios setoriais que abastecem os bairros (ilustração na ).
Tais ativos estão espalhados por um raio de cerca de 40 km, alguns deles em morros de difícil acesso, e precisam funcionar de forma coordenada 24 horas por dia.
O operador de plantão, sentado numa sala no centro da cidade, precisa responder a perguntas que parecem simples: o reservatório do bairro Centro está enchendo ou esvaziando? A bomba B da elevatória 3 está mesmo ligada, ou o disjuntor caiu de madrugada? A pressão no recalque está normal? E, se ontem à noite faltou água no bairro Alto, o que exatamente aconteceu e a que horas?
Nenhuma dessas perguntas é respondida por um controlador local.
Por padrão, o controlador liga e desliga a bomba muito bem, mas ele está lá no morro, sozinho, sem se comunicar com ninguém.
Neste sistema, o que falta é uma camada que observe tudo isso de longe, registre o que aconteceu e permita intervir.
Essa camada é o SCADA, sendo este o assunto de estudos desta aula.
Fig. 1 —
Exemplo ilustrativo de planta de produção de água e saneamento para uma cidade de porte médio.
O mesmo padrão em outros setores
Troque a água por outro insumo e o problema se repete quase sem alteração.
No setor elétrico, supervisionam-se subestações e linhas de transmissão, abrindo e fechando disjuntores remotamente.
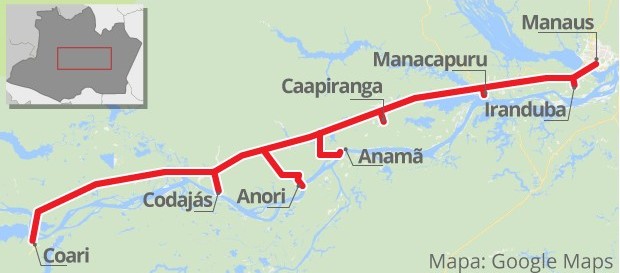
Em óleo e gás, acompanha-se pressão e vazão ao longo de dutos que cruzam centenas de quilômetros; um exemplo notório é o gasoduto Urucu-Coari-Manaus da Petrobras, que atravessa a floresta amazônica levando gás natural a diversas cidades do Amazonas (ilustrado na ).
Fig. 2 —
Mapa do gasoduto Coari-Manaus da Petrobras.
O elemento comum a todos esses casos é a combinação de três fatores:
dispersão geográfica
necessidade de operação coordenada
exigência de um registro histórico confiável.
Sempre que um sistema possui tais necessidades, o sistema SCADA se justifica como uma opção de arquitetura.
Sempre que os três aparecem juntos, aparece o SCADA.
O que é SCADA
SCADA (Supervisory Control and Data Acquisition) é uma arquitetura de hardware e software voltada à supervisão centralizada e à aquisição de dados de processos físicos distribuídos.
A palavra-chave é supervisão: o SCADA não substitui o controle local feito pelos controladores em campo, mas sim observa, registra, gera alarmes e permite ao operador intervir a partir de um ponto central, que pode estar a quilômetros dos equipamentos.
Em essência, o SCADA é a camada que integra sensores, atuadores e redes de comunicação de toda a operação.
Ele coleta as leituras dos sensores, exibe o estado dos atuadores e oferece um canal para enviar comandos, usando a rede como meio de transporte entre o campo e a central.
Note que o fluxo dominante de dados é de baixo para cima, i.e. normalmente, os dados sobem do campo para a central a um volume e frequência muito maior, sendo que o fluxo de dados da central para o campo é normalmente mais raro e pontual.
Tal assimetria explica boa parte das decisões de projeto que veremos adiante, da estratégia de aquisição ao desenho dos protocolos.
Nota
Pense no SCADA como a central de controle de uma operação espalhada geograficamente.
O controle de baixo nível continua acontecendo no campo; o SCADA dá visibilidade e controle de alto nível sobre o conjunto.
SCADA, PLC e DCS: não confundir
Três siglas costumam se misturar na cabeça de quem está começando, e vale separá-las logo de início.
Um PLC (Programmable Logic Controller, ou CLP em português) é um dispositivo que executa lógica de controle determinística em um ponto específico: lê entradas e aciona saídas em ciclos de varredura de milissegundos. É um controlador.
Um DCS (Distributed Control System) é uma arquitetura voltada ao controle contínuo e fortemente integrado de uma planta concentrada (e.g.,uma refinaria, uma fábrica de papel) onde controle e supervisão vivem dentro do mesmo sistema.
O SCADA, por sua vez, é mais adequado quando o processo é geograficamente disperso (e.g. rede de distribuição de água, malha elétrica, oleoduto) e a prioridade é a supervisão remota sobre links de comunicação que podem ser lentos ou intermitentes.
Em resumo: o PLC controla um ponto, o DCS controla uma planta integrada, e o SCADA supervisiona um sistema espalhado.
Aspecto
PLC
DCS
SCADA
Função principal
Controlar
Controlar e supervisionar
Supervisionar
Escopo
Uma máquina ou célula
Uma planta integrada
Um sistema disperso
Geografia
Local
Concentrada
Distribuída
Comunicação
Rede local rápida
Rede proprietária dedicada
Links lentos ou intermitentes
Exemplo típico
Envasadora
Refinaria
Rede de água da cidade
Dica
Regra prática: se o objetivo é controle local intensivo, pense PLC ou DCS; se é supervisão sobre grandes distâncias, pense SCADA. Na prática, sistemas modernos combinam os três.
A pirâmide da automação
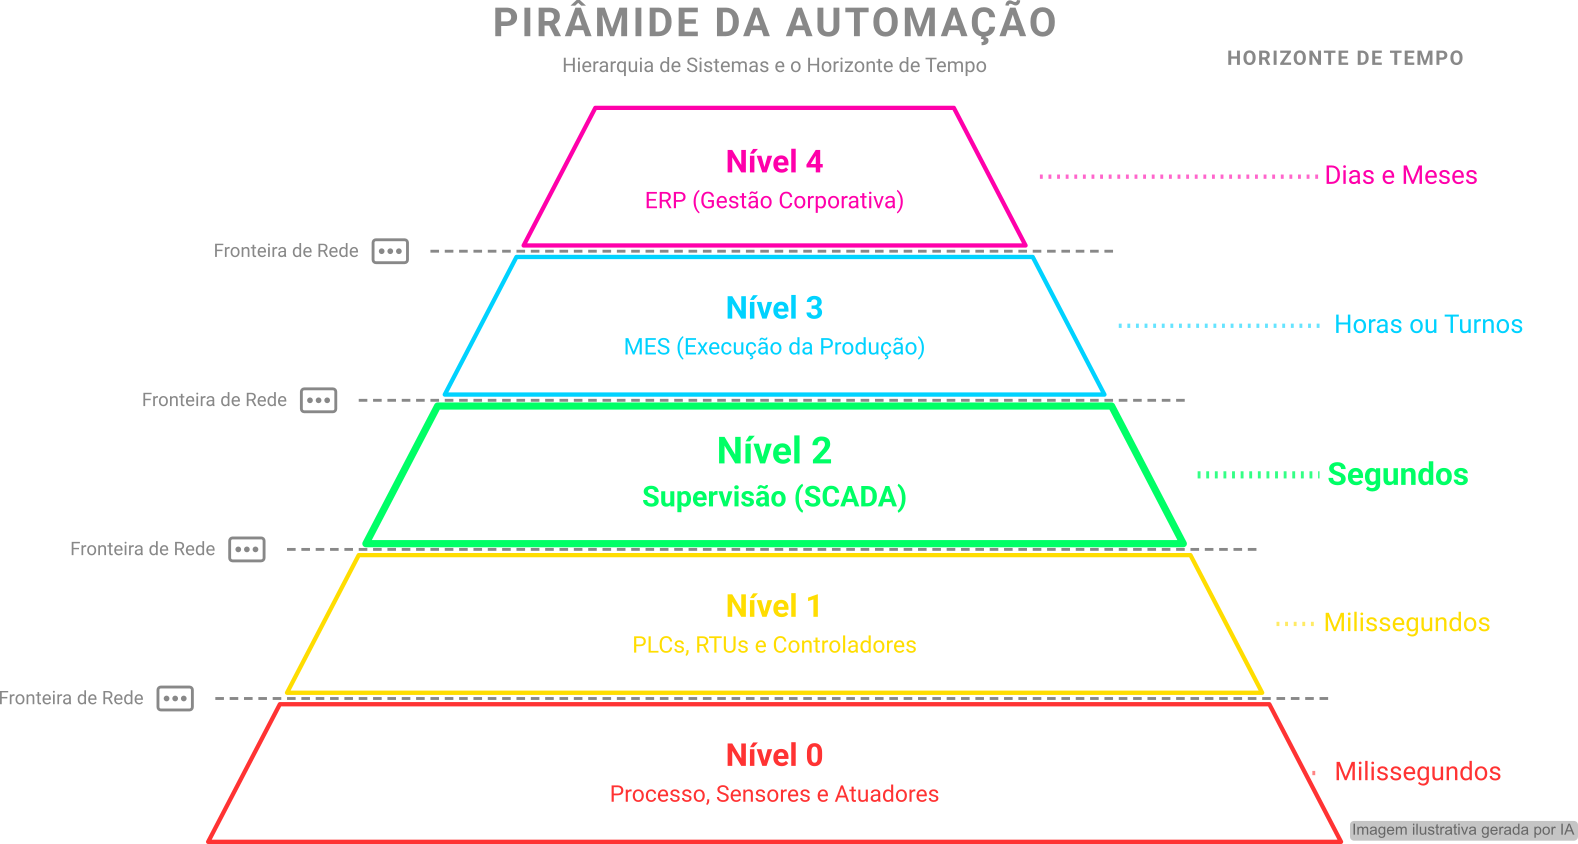
Para situar o SCADA dentro do conjunto maior dos sistemas de uma empresa industrial, usa-se tradicionalmente a chamada pirâmide da automação (), que organiza os sistemas em níveis segundo a sua proximidade com o processo físico e o seu horizonte de tempo.
A pirâmide de automação possui os seguintes níveis, de baixo para cima:
No nível 0 está o processo em si e a instrumentação: sensores e atuadores em contato direto com o mundo físico.
No nível 1 estão os controladores — PLCs, RTUs, controladores dedicados — que fecham as malhas de controle em milissegundos.
No nível 2 está a supervisão: é exatamente aqui que mora o SCADA, com suas telas, alarmes e histórico, operando em segundos.
No nível 3 está o MES (Manufacturing Execution System), que cuida da execução da produção, ordens, qualidade e rastreabilidade, em horas ou turnos. E no nível 4 está o ERP, o sistema de gestão corporativa, que trabalha em dias e meses.
Duas observações importam mais do que a pirâmide em si. A primeira é que o horizonte de tempo aumenta conforme se sobe: o nível 1 reage em milissegundos, o nível 4 planeja o trimestre. A segunda é que cada fronteira dessa pirâmide é também uma fronteira de rede e, portanto, uma fronteira de segurança. Guarde esta ideia: ela reaparecerá sob o nome de Modelo Purdue.
Fig. 3 —
Ilustração da pirâmide de automação
Nota
A pirâmide é um modelo didático, não uma fotografia. Arquiteturas modernas com IoT e nuvem frequentemente "furam" níveis, levando dados do campo direto para plataformas analíticas — com todos os ganhos e todos os riscos que isso implica.
Arquitetura de um sistema SCADA
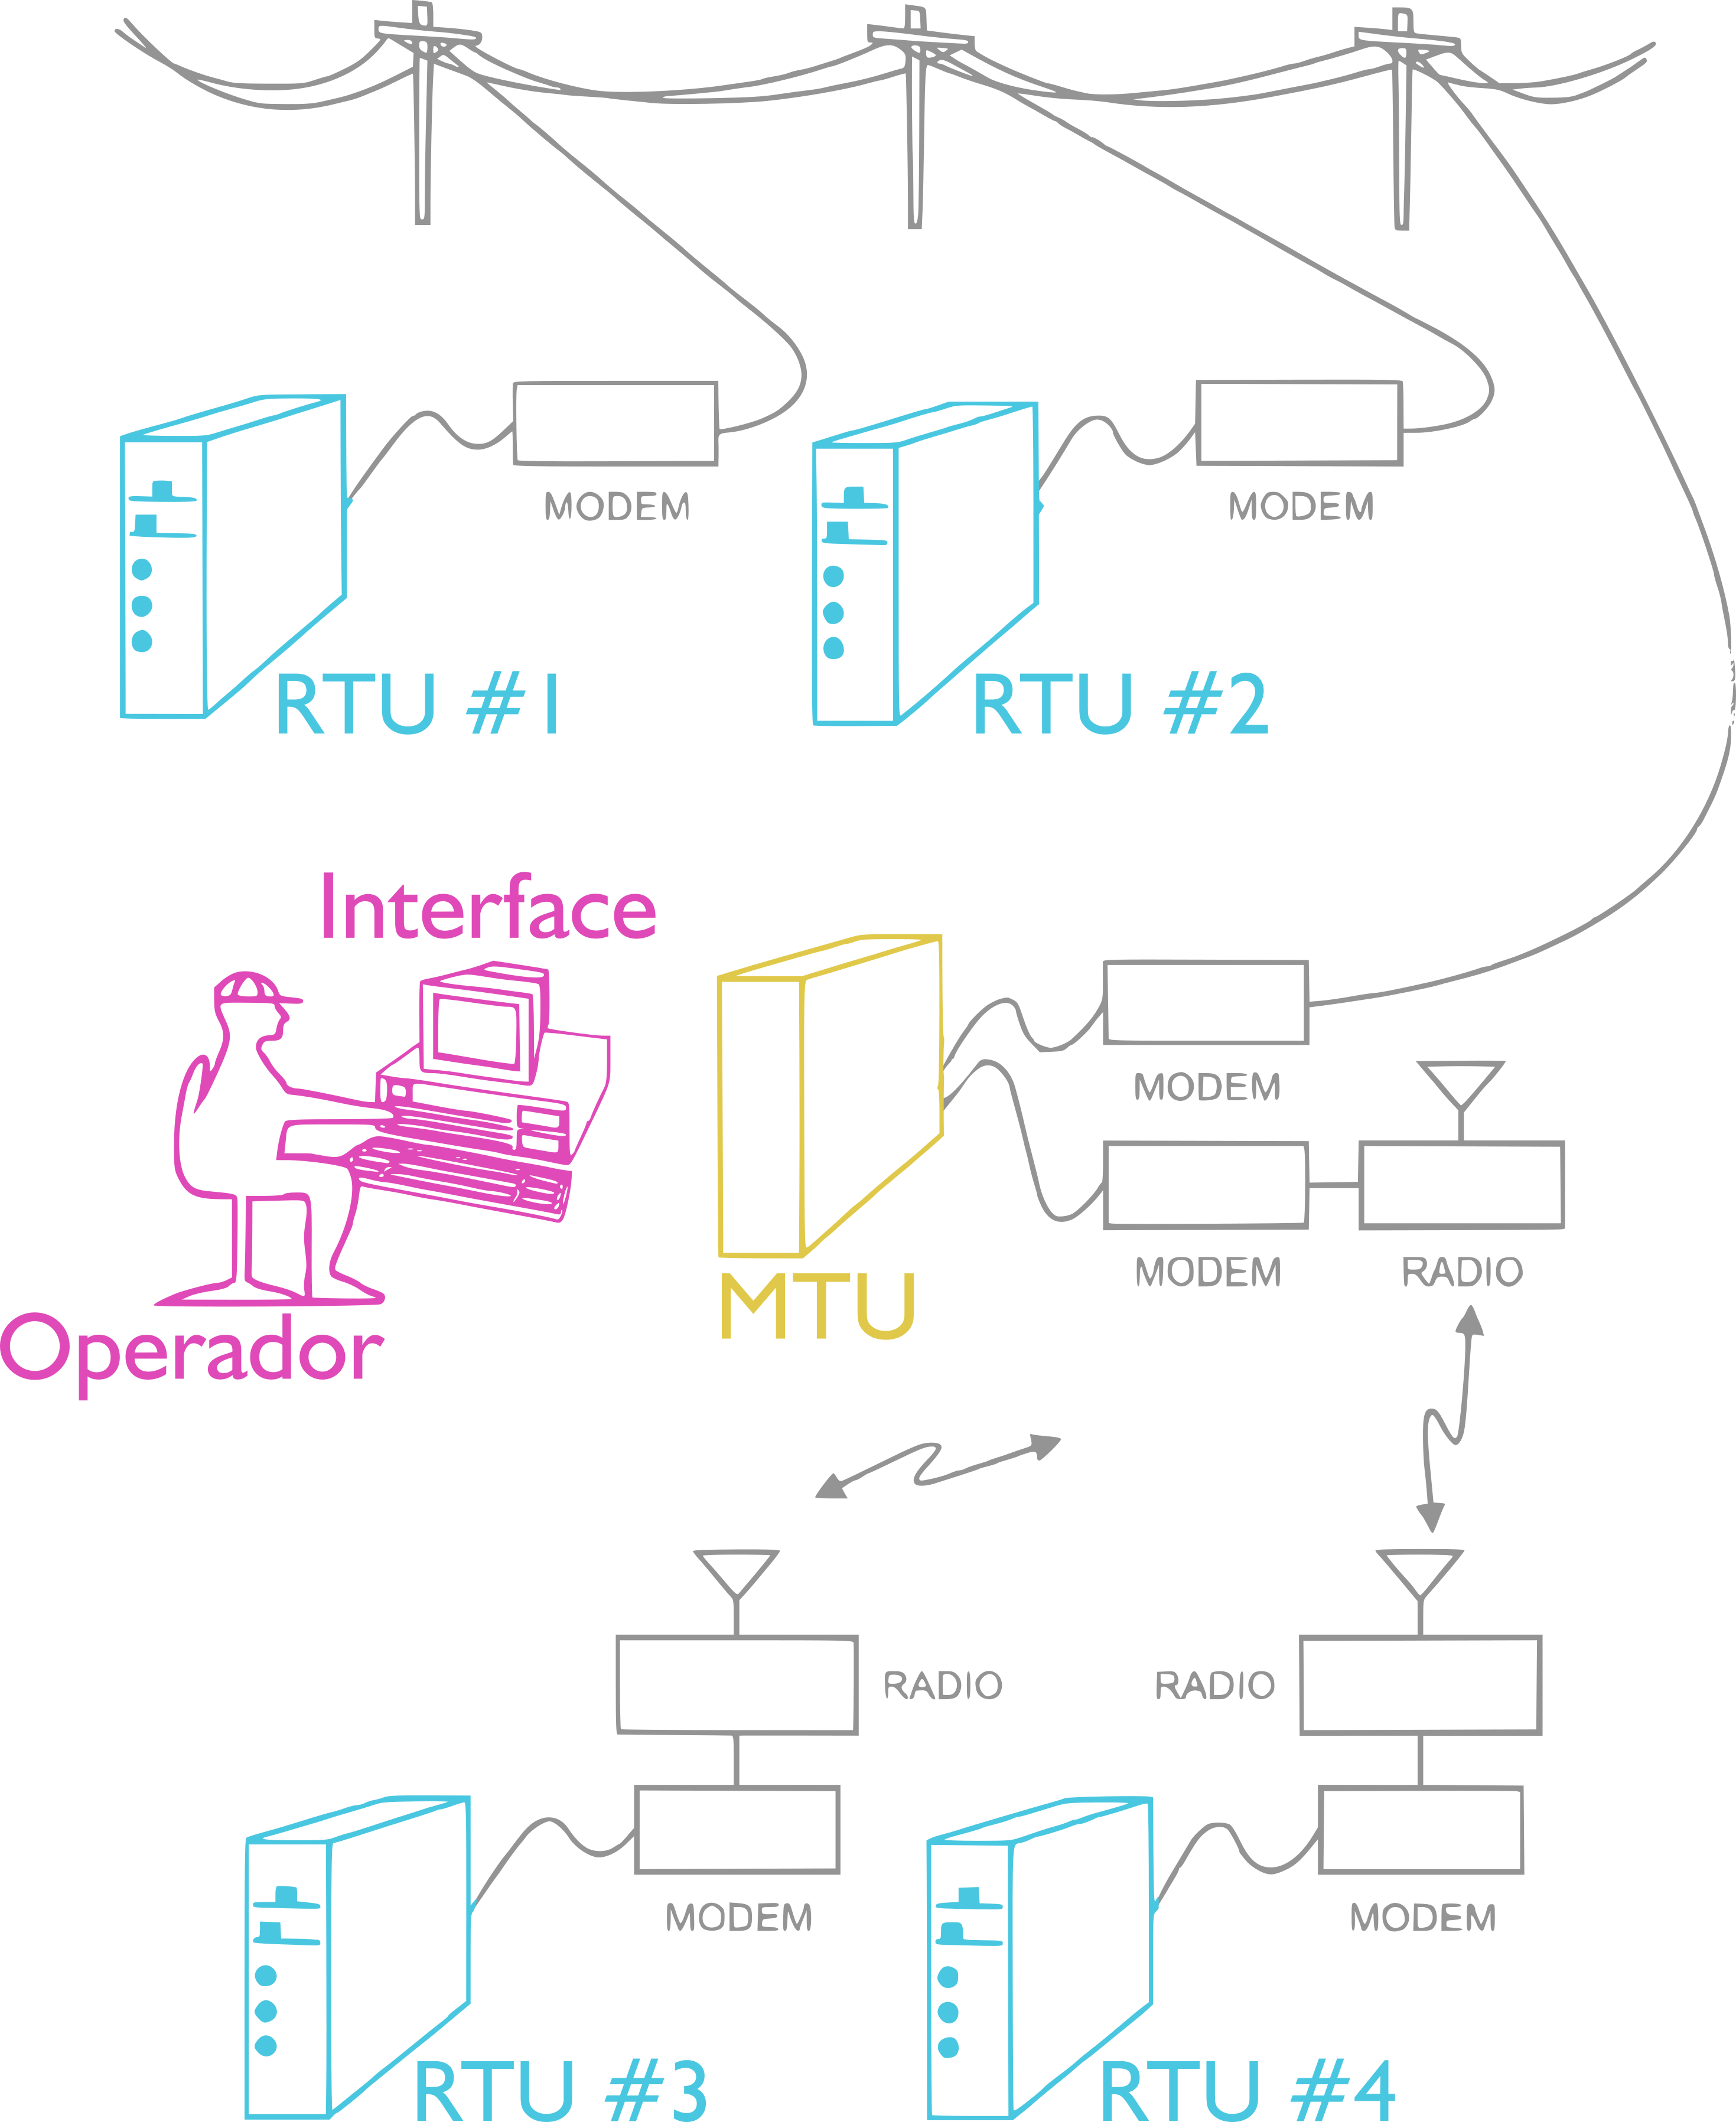
A arquitetura clássica do SCADA organiza-se em duas regiões distintas, ligadas por uma terceira que costuma receber menos atenção do que merece.
De um lado está o campo, onde ficam os dispositivos que medem e atuam sobre o processo. Do outro está a central, onde ficam os softwares de supervisão e armazenamento. Entre as duas está a infraestrutura de comunicação, que no nosso sistema de água exemplo precisa vencer 40 km, morros e a ausência de energia confiável em alguns pontos.
A ilustra essa organização. Vamos percorrer as três regiões, uma por vez.
Fig. 4 —
Esquemático ilustrando a arquitetura de um sistema SCADA.
O campo: as RTUs
No campo estão as RTUs (Remote Terminal Unit), dispositivos microprocessados capazes de interagir diretamente com sensores e atuadores e, ao mesmo tempo, comunicar-se em rede.
A RTU cumpre um duplo papel: realiza o controle local com baixa latência e serve de ponte entre os dispositivos de campo e o sistema SCADA.
No nosso sistema de água, cada elevatória e cada reservatório tem a sua RTU.
A RTU da elevatória 3 lê a pressão no recalque, o estado do disjuntor e a corrente de cada bomba; aciona os contatores; e responde às consultas da central.
Se a comunicação cair, ela continua ligando e desligando a bomba conforme a sua própria lógica, ou seja, o bairro não fica sem água só porque o rádio falhou.
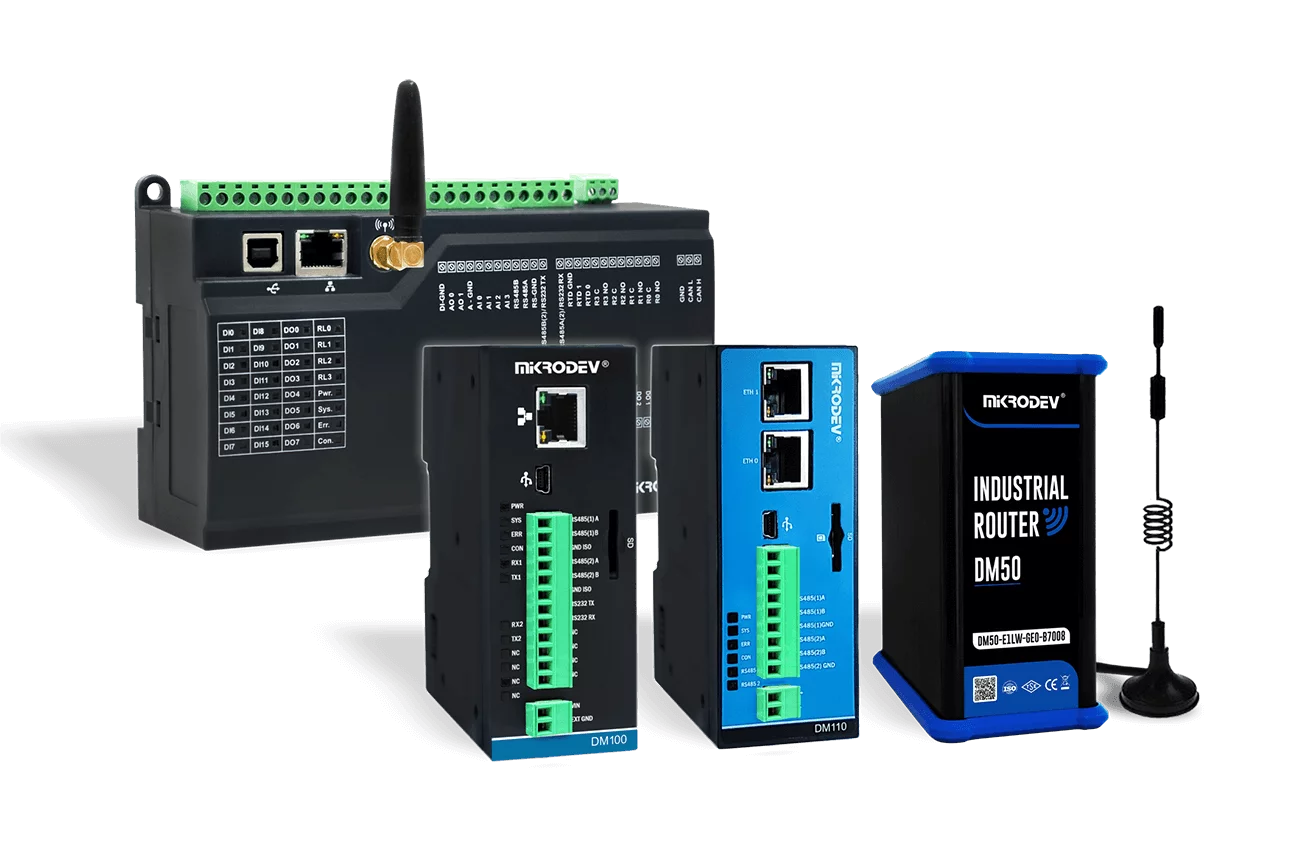
Do ponto de vista de equipamento, as RTUs foram originalmente dispositivos dedicados, com entradas e saídas digitais e analógicas, capacidade de programação e interface de rede embutida, como os da .
Hoje, diversos outros equipamentos exercem essa função: PLCs, data-loggers, controladores baseados em microcontroladores, e até computadores de placa única.
Fig. 5 —
Exemplos de Remote Terminal Unit (RTU).
Nota
Do ponto de vista do sistema SCADA, o termo "RTU" designa um papel: o dispositivo que está em campo, em contato com os instrumentos e em comunicação com a central. Do ponto de vista de equipamento, esse papel pode ser cumprido por tipos bem diferentes de hardware.
RTU ou PLC no campo?
A escolha entre RTU e PLC depende do problema.
A RTU nasceu da telemetria e do telecontrole: é otimizada para sites remotos, dispersos e muitas vezes sem energia confiável, comunicando-se bem por links lentos ou intermitentes.
O PLC nasceu do controle de máquinas: é otimizado para lógica de controle intensiva e determinística dentro de uma planta concentrada, com redes locais rápidas à disposição.
Na prática moderna não há fronteira nítida entre os dois.
Muitos PLCs incorporam recursos de telemetria e muitas RTUs executam lógica de controle sofisticada.
Ainda assim, a distinção de origem ajuda a decidir qual dispositivo se encaixa melhor em cada ponto da operação.
No nosso exemplo, a estação de tratamento, concentrada e com lógica de dosagem intensiva, pede PLC; o reservatório no alto do morro, com painel solar e rádio, pede RTU.
Aspecto
RTU
PLC
Origem
Telemetria e telecontrole
Controle de máquinas
Geografia
Sites dispersos e remotos
Planta concentrada
Comunicação
Robusta em links lentos
Redes locais rápidas
Lógica de controle
Mais simples
Intensiva e determinística
Alimentação
Tolerante (solar, bateria)
Rede industrial estável
O meio de comunicação
A infraestrutura de comunicação costuma aparecer nos diagramas como uma única linha ligando campo e central, o que esconde o fato de que ela é, quase sempre, a maior restrição de projeto de um sistema SCADA.
Vale a pena abri-la.
Rádio ponto-a-multiponto em faixas licenciadas ou não licenciadas foi, durante décadas, o meio clássico do SCADA.
É barato de operar depois de instalado, não depende de terceiros e funciona onde não há mais nada.
Entretanto, exige visada direta, tem banda modesta e sofre com interferência e chuva.
Redes celulares (4G e, crescentemente, NB-IoT e LTE-M) são hoje a escolha padrão para ativos dispersos em área urbana e periurbana.
São rápidas de implantar e razoavelmente baratas, mas introduzem uma dependência de terceiros, custo por volume de dados e uma latência que varia com a carga da célula.
É o que usaríamos nas elevatórias da nossa cidade.
Fibra óptica oferece banda e latência excelentes e imunidade eletromagnética, sendo a escolha natural dentro da estação de tratamento ou entre prédios próximos.
Fora disso, o custo de obra civil geralmente inviabiliza.
Satélite resolve o ativo verdadeiramente isolado (e.g., uma estação no meio da floresta, uma plataforma).
Cobre qualquer lugar, ao custo de uma latência alta e de um custo por byte que torna o report-by-exception praticamente obrigatório.
A tabela a seguir resume as ordens de grandeza.
Repare que a diferença entre a primeira e a última linha é de várias ordens de magnitude, e é justamente essa diferença que faz a estratégia de aquisição de dados ser uma decisão de engenharia, e não um detalhe de configuração.
Meio
Latência típica
Banda
Custo operacional
Uso típico no exemplo
Fibra óptica
< 5 ms
Alta
Baixo (obra alta)
Dentro da ETA
Rádio licenciado
50–200 ms
Baixa
Muito baixo
Reservatórios em morro
Celular 4G / LTE-M
50–300 ms
Média
Médio (por dado)
Elevatórias urbanas
Satélite
600 ms–1,5 s
Baixa
Alto
Captação isolada
Atenção
Um erro comum de projeto é dimensionar as taxas de varredura na mesa, com base no que o processo "pediria", e só depois descobrir que o link não sustenta aquele volume. O meio de comunicação deve entrar na conta desde o primeiro dia.
A central: a MTU
No centro do sistema está a estação supervisória, historicamente chamada de MTU (Master Terminal Unit).
É ela quem inicia os ciclos de aquisição, consolida os dados recebidos do campo, dispara alarmes, encaminha os comandos do operador aos atuadores, registra o histórico e gera relatórios.
Do ponto de vista de equipamento, a MTU é normalmente um servidor (ou um conjunto deles) executando vários softwares em conjunto.
Como exemplos de softwares que são comumente executados na MTU, listam-se: o servidor de comunicação que fala os protocolos de campo; o servidor de tags que mantém os valores correntes; o motor de alarmes; o banco de dados histórico; o servidor das telas que os operadores acessam; etc..
Vale notar que "MTU" é um termo que vem da tradição do telecontrole e que, na documentação comercial de hoje, aparece frequentemente sob outros nomes: servidor SCADA; servidor de supervisão; front-end processor para a parte de comunicação. A função é a mesma independente do nome.
Quando o link cai: redundância e autonomia
Um sistema SCADA é, antes de tudo, um sistema que precisa estar disponível.
Isso se traduz em decisões concretas de arquitetura, e não apenas em boas intenções.
Na central, a prática consolidada é a redundância quente (hot standby): um servidor principal executa o sistema e um servidor secundário espelha continuamente softwares e dados, pronto para assumir.
A troca é arbitrada por um watchdog, que é um mecanismo que monitora sinais de vida do principal e promove o secundário quando eles cessam.
O ponto delicado desse arranjo é evitar o chamado split-brain, situação em que os dois servidores se julgam ativos simultaneamente e passam a enviar comandos conflitantes ao campo.
No campo, a pergunta relevante é: o que a RTU faz quando perde a comunicação com a central?
Um sistema bem projetado responde em três camadas.
Primeiro, a RTU continua executando sua lógica local, mantendo o processo em operação segura.
Segundo, ela armazena localmente as leituras que não conseguiu transmitir — o chamado store-and-forward — e as envia, com os respectivos carimbos de tempo, assim que o link volta.
Terceiro, ela entra em um modo degradado previamente definido caso a falha persista além de um limite: no nosso reservatório, por exemplo, manter o enchimento apenas dentro de uma faixa conservadora de nível.
A pior arquitetura possível é aquela em que a inteligência toda mora na central e o campo é puramente passivo.
Nela, a queda de um rádio vira desabastecimento.
Perigo
Nunca projete um sistema em que a perda de comunicação com a central deixe o processo sem controle. O SCADA supervisiona; ele não deve ser o único lugar onde a lógica de segurança existe.
A tag: unidade fundamental do dado
Toda informação que circula em um sistema SCADA é organizada em torno de uma unidade fundamental: a tag.
Cada grandeza monitorada ou controlada do processo (e.g., o nível de um reservatório, o estado de uma bomba, a pressão em um ponto do recalque) corresponde a uma tag.
A tag não é apenas um número.
Ela associa um nome legível a uma fonte física no campo, a uma unidade de engenharia, a uma taxa de varredura e a uma configuração de alarmes.
Telas, alarmes, históricos e relatórios são todos construídos sobre tags; um sistema SCADA real é, essencialmente, uma grande coleção de definições de tags.
Definição 1·Tag
Uma tag é a representação lógica de uma grandeza monitorada ou controlada no SCADA. Ela associa:
um nome inteligível (ex.: RSV_CENTRO_NIVEL);
uma fonte física no campo (ex.: um registrador de uma RTU);
uma unidade de engenharia (ex.: %, m³/h, mca);
uma taxa de varredura (de quanto em quanto tempo o valor é coletado);
uma configuração de alarmes (limites e prioridades).
Toda a operação — telas, alarmes, históricos e relatórios — é construída sobre tags.
Nomear bem é metade do projeto
Em um sistema com algumas dezenas de tags, o nome de cada uma parece um detalhe.
Em um sistema com dez mil, a convenção de nomenclatura é o que separa um sistema operável de um sistema incompreensível (e o custo de renomeá-la após a implantação do sistema é altíssimo).
Uma convenção útil é hierárquica e legível da esquerda para a direita, indo do mais geral ao mais específico: instalação, equipamento, grandeza, qualificador.
Aplicada ao nosso sistema de água, ela produz nomes como os abaixo.
Tag
Significado
RSV_CENTRO_NIVEL
Nível do reservatório do Centro, em %
EEB_03_BOMBA_A_STAT
Estado da bomba A da elevatória 3 (ligada/desligada)
EEB_03_BOMBA_A_CORR
Corrente da bomba A da elevatória 3, em A
EEB_03_PRES_REC
Pressão no recalque da elevatória 3, em mca
ETA_VAZAO_TRAT
Vazão tratada na estação, em m³/h
O ponto não é adotar exatamente esta convenção, e sim adotar alguma convenção, documentá-la e fazê-la valer.
Um operador experiente deve conseguir adivinhar o nome de uma tag que nunca viu.
Exemplo 16·Definição de uma tag
O exemplo a seguir faz a definição de uma tag para o sistema SAAE de exemplo deste módulo.
A configuração esquemática de uma única tag reúne tudo o que foi dito até aqui.
Repare que a fonte aponta para um registrador de uma RTU específica, a varredura define a frequência de coleta e os alarmes amarram limites a prioridades.
yaml
tag:
  nome: RSV_CENTRO_NIVEL
  descricao: Nível do reservatório setorial do Centro
  fonte: RTU_CENTRO/HR0      # holding register 0 da RTU do Centro
  unidade: "%"
  escala: { bruto: [0, 4095], engenharia: [0.0, 100.0] }
  varredura_ms: 5000         # coleta a cada 5 s
  alarmes:
    - tipo: HIGH
      limite: 95
      prioridade: alto
      deadband: 2
    - tipo: LOW
      limite: 20
      prioridade: critico
      deadband: 2
Qualidade e tempo de uma tag
Um valor de tag, sozinho, não é informação suficiente.
Duas perguntas precisam sempre acompanhá-lo: este valor é confiável? e de quando ele é?
A primeira é respondida pelo atributo de qualidade.
Sistemas SCADA sérios não representam uma tag apenas por um número, mas por um par valor-qualidade, tipicamente com três estados: good, quando a leitura foi obtida normalmente; bad, quando houve falha de comunicação, sensor fora de faixa ou erro de conversão; e uncertain, quando o valor foi obtido mas há motivo para desconfiança (e.g., um dado antigo que ainda não foi atualizado).
O perigo de ignorar a qualidade é sutil e grave: uma tela que exibe o último valor conhecido sem indicar que a comunicação caiu mente para o operador.
Ele vê um nível de 60% estável e tranquilizador, quando na verdade não se sabe nada sobre aquele reservatório há vinte minutos.
A segunda pergunta é respondida pelo carimbo de tempo (timestamp), e ela é mais delicada e complexa do que parece.
O valor deve ser carimbado onde foi medido, na RTU, e não onde foi recebido, na central; do contrário, um atraso de comunicação vira uma mentira sobre quando o evento aconteceu.
Isso exige que todas as RTUs tenham relógios sincronizados, via NTP na maioria dos casos ou PTP quando se exige precisão sub-milissegundo.
Sem sincronismo, a sequência de eventos (SOE) torna-se irreconstruível: depois de um incidente, não se consegue dizer se a bomba parou porque a pressão caiu ou se a pressão caiu porque a bomba parou.
Em sistemas elétricos, essa distinção é a própria finalidade do registro.
Atributo
Pergunta que responde
Mecanismo
Falha se ausente
Valor
Quanto?
Conversão bruto → engenharia
Leitura sem sentido físico
Qualidade
É confiável?
Flags good / bad / uncertain
Tela mostra dado velho como atual
Carimbo de tempo
De quando?
Timestamp na origem + NTP/PTP
Sequência de eventos irreconstruível
Atenção
Ao especificar um sistema SCADA, exija explicitamente que a IHM represente visualmente a qualidade da tag — valores com qualidade ruim devem aparecer diferentes dos bons. É um requisito barato de pedir na especificação e caro de acrescentar depois.
Como o SCADA adquire dados
A aquisição de dados é o atributo fundamental do SCADA, e ela acontece de forma bem diferente do que se vê em sistemas de TI convencionais. Como os links para o campo costumam ter banda limitada e latência alta — como vimos na seção sobre meios de comunicação —, a estratégia de coleta precisa ser econômica.
Há duas abordagens fundamentais, que não se excluem e que na prática são combinadas:
O polling é a coleta por pergunta: a central interroga periodicamente cada dispositivo sobre o seu estado atual. É simples, previsível e não exige quase nada do dispositivo de campo.
O report-by-exception é a coleta por evento: os dispositivos de campo só transmitem quando há mudança significativa, economizando banda de forma drástica em processos estáveis.
Sobre os dados assim obtidos, o SCADA constrói três serviços essenciais: as tendências, os alarmes e o registro histórico.
Polling
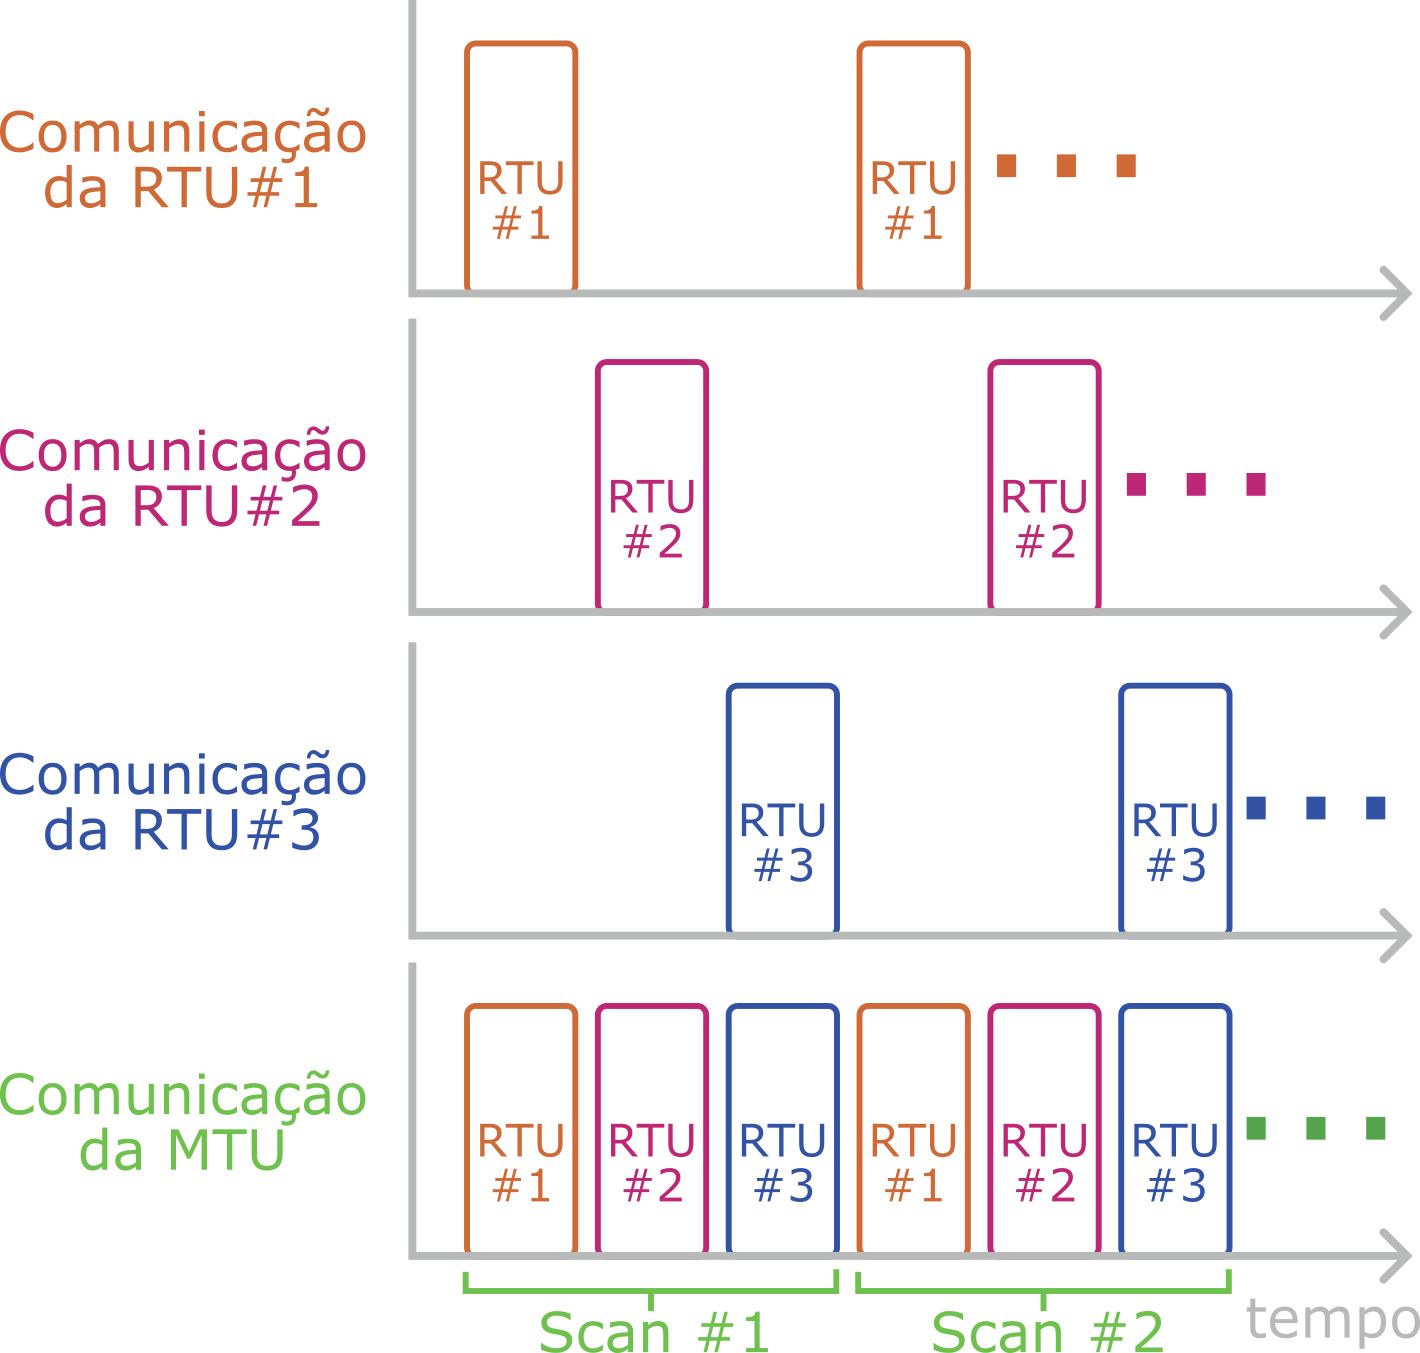
No modelo de polling, a MTU percorre a lista de dispositivos em ciclos chamados scan. O tempo total de um ciclo cresce com o número de dispositivos consultados e com o tempo de ida e volta de cada consulta, conforme ilustra a .
Podemos estimar o tempo de um ciclo completo como o somatório, sobre os dispositivos, do tempo de requisição, do tempo de resposta e do tempo de processamento de cada resposta:
onde é o número de dispositivos consultados, e são os tempos de requisição e resposta no canal, e é o tempo de processamento por resposta. A segunda igualdade vale quando os dispositivos são homogêneos; com dispositivos heterogêneos, mantém-se o somatório.
Fig. 6 —
Ciclos de scan da MTU em relação às RTUs. Quanto mais RTUs são consultadas, maior é o tempo de um scan completo.
Exemplo 17·Estimando o ciclo de polling
Uma central faz polling de 50 RTUs. Cada consulta consome, em média, 40 ms de ida e volta no canal e 10 ms de processamento. Qual o tempo aproximado de um ciclo completo?
Considerando ms e ms por dispositivo, temos 50 ms por RTU. Aplicando Eq. …:
Ou seja, cada tag dessas RTUs só é atualizada a cada 2,5 s. Para um processo rápido, isso pode ser inaceitável — e é daí que nasce a necessidade do report-by-exception.
Escolhendo a taxa de varredura
A equação anterior diz quanto tempo um ciclo leva. Falta a outra metade da pergunta de projeto: quanto tempo ele poderia levar? Ou seja, de quanto em quanto tempo cada grandeza precisa ser amostrada para que o SCADA não perca informação relevante sobre o processo.
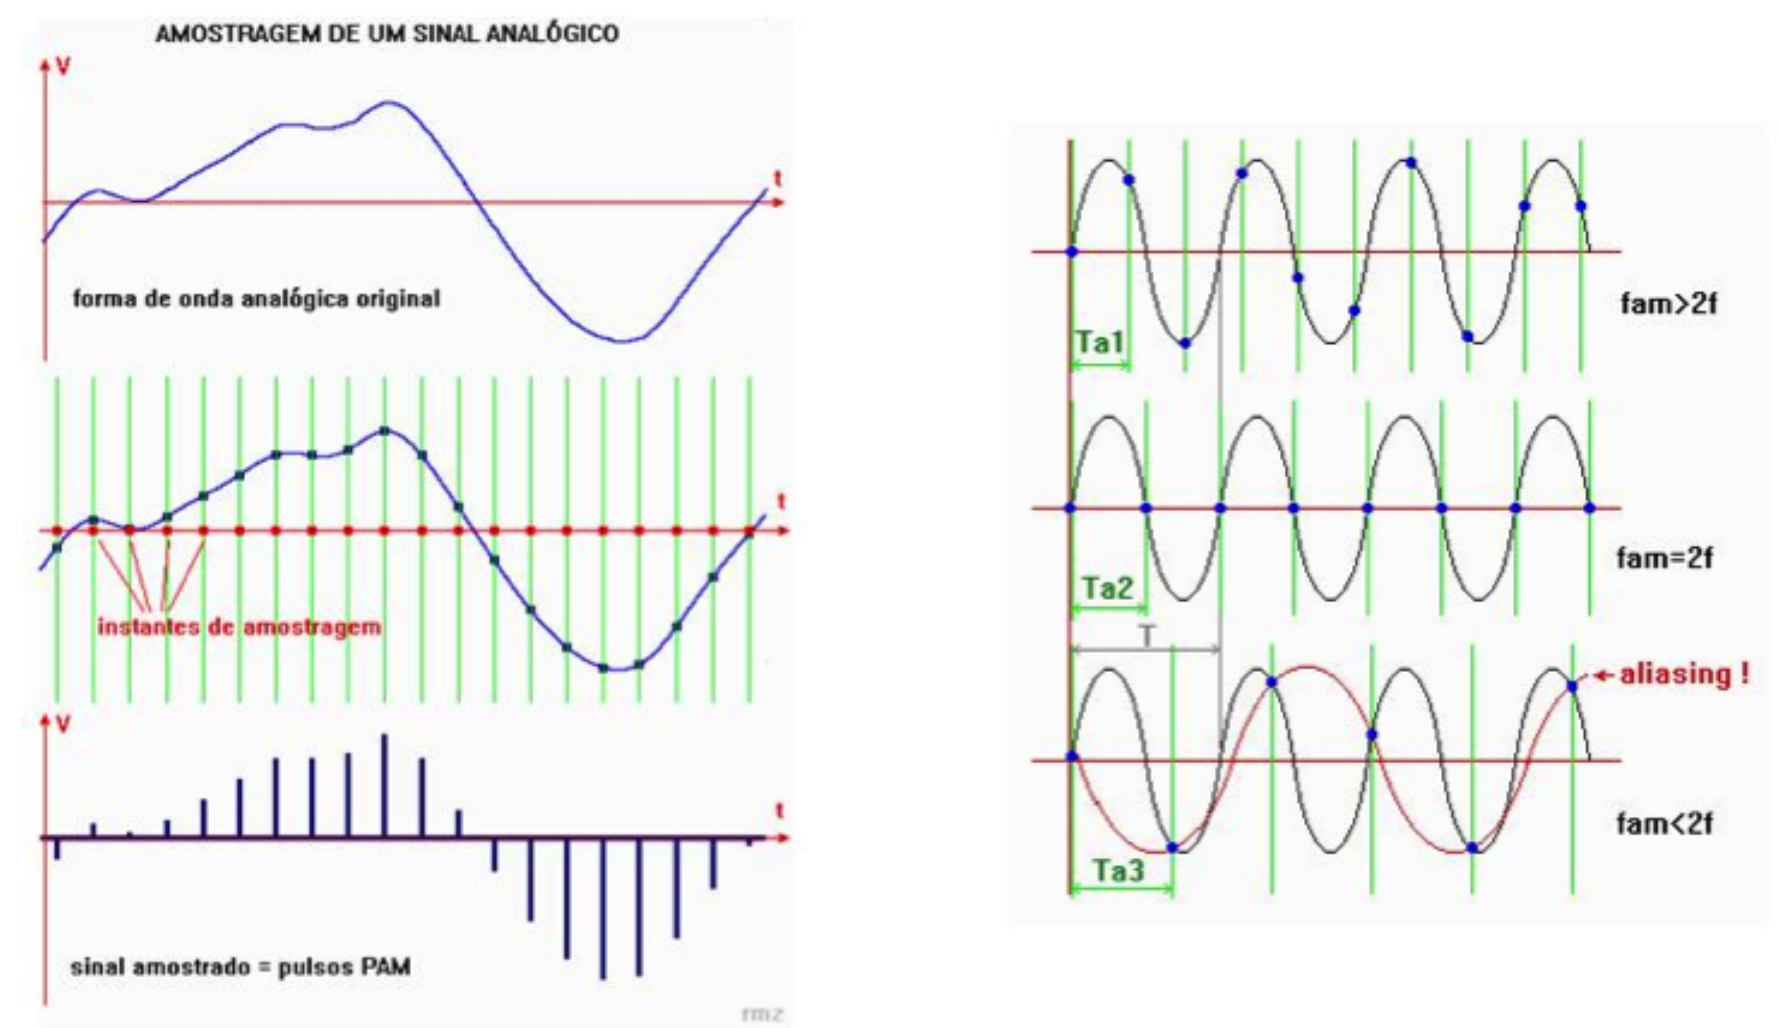
O piso teórico para essa escolha é dado pelo princípio de Nyquist: para que um sinal contínuo de frequência máxima seja amostrado sem perda significativa de informação e sem que ocorra aliasing, a frequência de amostragem deve ser pelo menos o dobro de , isto é, (a ilustra o efeito).
Quando esse princípio é violado, aparecem efeitos estroboscópicos entre a grandeza do mundo físico e a leitura do sensor, de forma que o sinal amostrado passa a exibir uma frequência que simplesmente não existe no processo.
Os vídeos ao final desta seção demonstram o fenômeno de forma visual.
Na prática de supervisão, porém, Nyquist é um piso, não uma meta.
Amostrar no dobro da frequência máxima preserva a informação em princípio, mas produz uma tendência visualmente ilegível e atrasa demais a detecção de alarmes.
A regra prática é amostrar entre cinco e dez vezes a frequência da dinâmica mais rápida que se deseja acompanhar, de modo que:
Fig. 7 —
Exemplo do princípio de Nyquist aplicado a uma onda senoidal.
Temos agora duas restrições que apontam em sentidos opostos. A Eq. … diz que o scan precisa ser rápido o bastante para a dinâmica do processo. A Eq. … diz que o scan fica lento na medida em que crescem os dispositivos consultados. Combinando as duas, obtemos diretamente o número máximo de dispositivos que um único ciclo de polling pode atender:
Essa é a conta que sustenta decisões de arquitetura reais: quando é menor do que o número de RTUs que se tem na planta, não há configuração que resolva.
É preciso mudar alguma coisa estrutural (e.g. dividir os dispositivos entre canais de comunicação paralelos, separar as tags em grupos de varredura com períodos diferentes, ou migrar as grandezas rápidas para report-by-exception).
E isso conduz à conclusão mais importante desta seção: a taxa de varredura é atributo da tag, não do sistema. Não existe "o scan" de um SCADA bem projetado; existem grupos de varredura, cada um com o período que a sua dinâmica justifica.
Como exemplo, amostrar o nível de um reservatório de 500 m³ a cada 200 ms é desperdiçar banda que faz falta em outro lugar.
Report-by-exception
O report-by-exception contorna a limitação do tempo de scan ao silenciar os dispositivos cujo estado não variou substancialmente, liberando o canal para os eventos que realmente importam. Em um processo estável (comumente os processos industriais o são), a economia de banda é de uma ou duas ordens de grandeza.
O preço é uma complexidade maior no dispositivo de campo, que precisa manter o último valor reportado, avaliar o critério de mudança e gerenciar o buffer de transmissão. Há também uma sutileza operacional importante: no polling, o silêncio de um dispositivo é imediatamente detectado como falha; no report-by-exception, silêncio pode significar "nada mudou" ou "o dispositivo morreu". Por isso, sistemas baseados em report-by-exception sempre incluem uma mensagem periódica de vida (heartbeat) ou um polling de fundo, lento, apenas para confirmar que o dispositivo continua lá.
A escolha entre os dois modelos — ou, mais frequentemente, a combinação deles — é uma decisão de engenharia que depende da volatilidade do processo e das características do canal.
Critério
Polling
Report-by-exception
Iniciativa
Central
Campo
Uso de banda
Constante e previsível
Proporcional aos eventos
Detecção de falha
Imediata
Exige heartbeat
Complexidade no campo
Mínima
Moderada
Melhor para
Poucos dispositivos, link bom
Muitos dispositivos, link caro
Tendências, historian e o valor do histórico
Coletado o dado, resta armazená-lo. O historian é o banco de dados especializado que registra a evolução das tags ao longo do tempo. Não é um banco relacional comum: ele é otimizado para séries temporais, com compressão por desvio (guarda-se um ponto apenas quando ele se afasta o suficiente da reta que os pontos anteriores descreviam) e com políticas de retenção que mantêm dados recentes em resolução plena e dados antigos em resolução agregada.
É essencial distinguir o dado em tempo real do dado histórico. O valor de agora orienta a operação imediata e alimenta as leis de controle e a geração de alarmes. A série temporal, por outro lado, serve a um conjunto inteiramente diferente de propósitos: análise de tendência, auditoria regulatória, investigação de incidentes, manutenção preditiva e gestão administrativa da planta.
No nosso sistema de água, o histórico responde às perguntas que o tempo real não alcança. Por que o bairro Alto ficou sem água na terça? A curva de nível do reservatório mostra que ele esvaziou às 5h40, e o histórico de status da bomba mostra que ela parou às 4h15 — a resposta está na diferença entre os dois carimbos de tempo. A corrente da bomba B vem subindo 3% ao mês há um semestre? É um mancal indo embora, e é possível trocá-lo em manutenção programada em vez de esperar a falha num domingo à noite.
Exemplo 18·Dimensionando a varredura do sistema de água
No nosso sistema de abastecimento, três grandezas têm dinâmicas muito diferentes:
o nível dos reservatórios varia de forma apreciável a cada 20 de minutos;
o estado das bombas muda algumas vezes por hora, em eventos discretos;
a pressão no recalque sofre transientes de golpe de aríete na escala de centenas de milissegundos ( ms).
Considerando um sistema SCADA central, proponha uma estratégia de aquisição para estas três grandezas.
Pode-se analisar cada tipo de grandeza e, se adequado, aplicar a Eq. … a cada variável separadamente.
Pergunte, para cada uma, se ela precisa mesmo chegar à central com aquela resolução, ou se poderia ser tratada no campo.
Nível. Com variação apreciável em cerca de 20 minutos, temos que a frequência máxima do sistema é de Hz.
A regra prática pede s.
Assim, uma varredura de, por exemplo, 5 s é folgadamente suficiente e ainda dá uma tendência bonita de ler.
Estado das bombas. Não é um sinal contínuo, e sim um evento discreto. Nyquist não se aplica, além de que fazer polling a cada 5 s para capturar uma mudança que ocorre em média duas vezes por hora é puro desperdício de banda.
O tratamento correto é report-by-exception (necessariamente, com carimbo de tempo na origem).
Pressão. Considerando que Hz, o tempo de scan necessário na central deveria ser de ms na MTU, o que poderia consumir todo o canal de comunicação para única grandeza. A solução seria não levar esse sinal cru para a MTU.
A RTU poderia amostrar localmente a 10 ms, detectar o transiente com a lógica própria e enviar à central apenas o evento (e.g., "transiente detectado às 03:14,120, pico de 78 mca") mais os valores agregados de rotina (e.g., média, mínimo e máximo) a cada 5 s.
A lição geral é que nem toda grandeza rápida precisa de um link rápido.
Muitas vezes, a resposta certa é processar no campo e transmitir a conclusão.
Exemplo 19·Quantas RTUs cabem no canal?
Um canal de rádio apresenta ms e a MTU consome ms por resposta. O processo mais rápido que se deseja acompanhar por esse canal tem dinâmica de 30 s.
(a) Qual o período de scan desejável?
(b) Quantas RTUs esse canal comporta?
(c) O sistema tem 40 RTUs; o que fazer?
Use Eq. … para o item (a) e Eq. … para o item (b). No item (c), lembre que há mais de uma saída estrutural possível.
(a) Com dinâmica de 30 s, . A regra prática dá s.
(b) Cada dispositivo custa ms. Logo:
(c) Com 40 RTUs e capacidade para 15, o problema é estrutural, sendo que nenhuma configuração de sistema resolveria.
As saídas viáveis poderiam ser:
Dividir em canais paralelos: três canais de rádio em frequências distintas, com cerca de 13 RTUs cada, voltando à faixa viável.
Separar grupos de varredura: se apenas 10 das 40 RTUs monitoram o processo rápido, coloque-as em um grupo de 3 s e as outras 30 em um grupo de 30 s.
Migrar para report-by-exception: se o processo é estável a maior parte do tempo, o tráfego médio cai drasticamente e o canal passa a comportar todas.
Na prática, um projeto real geralmente combina as três.
Do dado ao operador
Até agora neste módulo, percorremos o caminho do dado desde o processo físico até a central: vimos o que é o SCADA e onde ele mora na pirâmide da automação, desmontamos a sua arquitetura em campo, comunicação e central, e estudamos a tag como unidade fundamental do dado, com os seus atributos de qualidade e tempo.
Fechamos com as duas estratégias de aquisição (polling e report-by-exception) e com a conta que dimensiona a rede de aquisição.
O dado agora está na MTU. A partir daqui, três perguntas organizam o restante do módulo.
A primeira é como esse dado é informado ao operador de forma que ele consiga compreendê-lo de forma facilitada e também agir sobre o processo. É o tema da IHM e dos alarmes, e é onde a engenharia encontra a psicologia do trabalho.
A segunda questão é como se protege um sistema SCADA, quando ele deixou de ser isolado e passou a controlar infraestrutura da qual dependem centenas de milhares de pessoas.
A IHM e a norma ISA-101
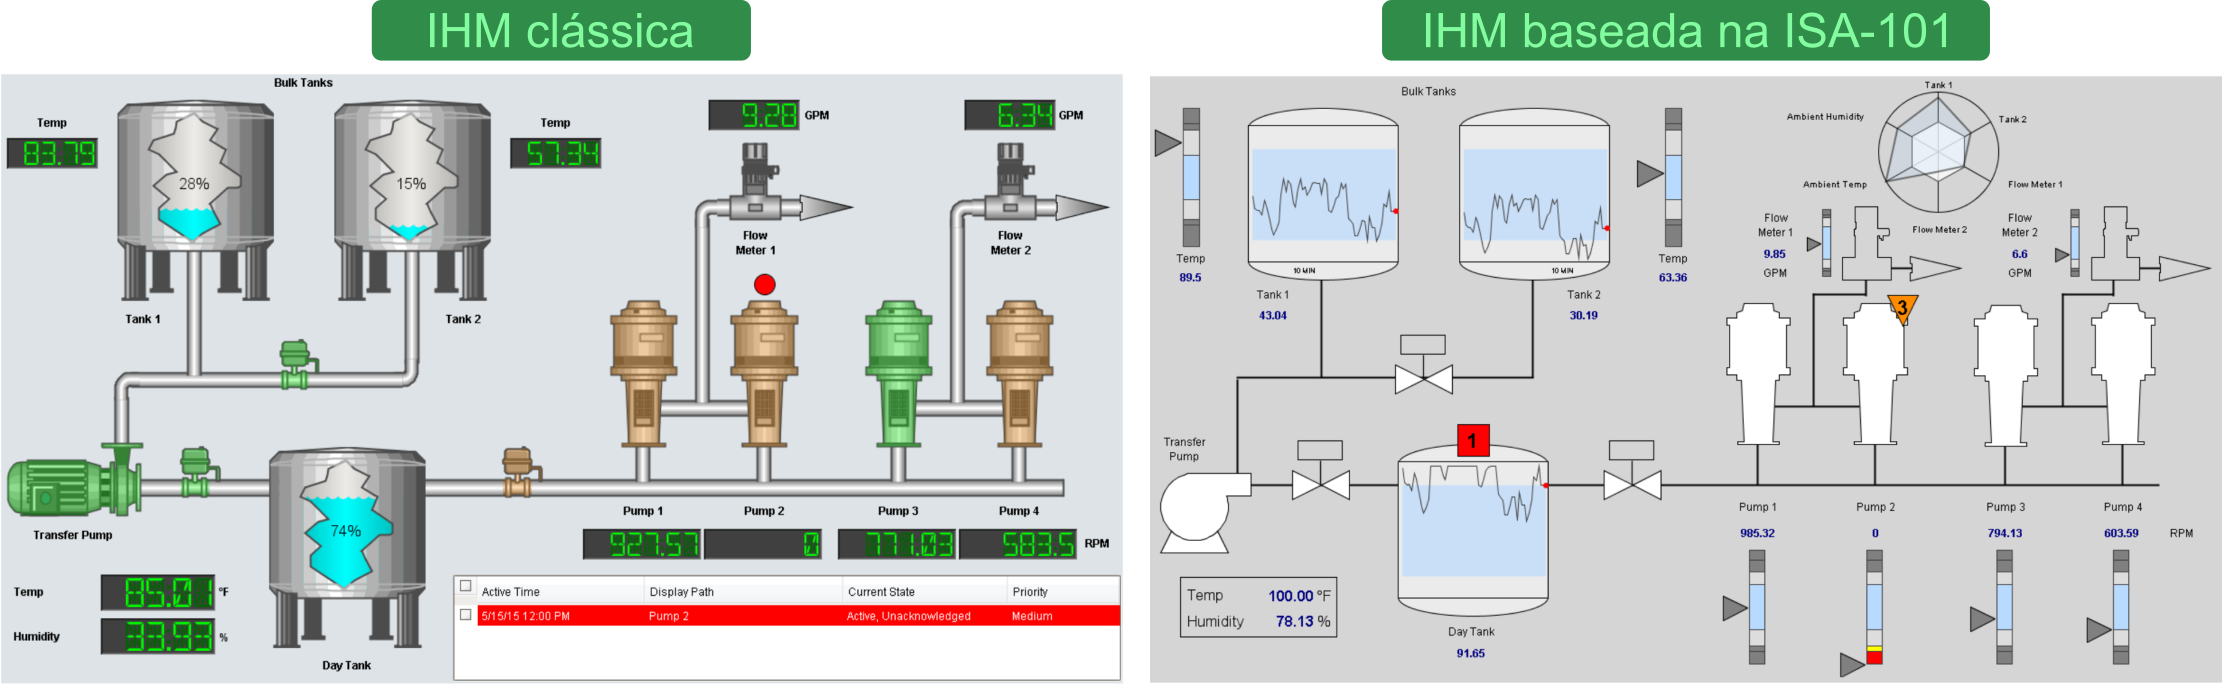
A IHM (Interface Homem-Máquina), ou tela supervisora, é a interface que permite ao operador visualizar de maneira inteligível os dados contidos na MTU e agir sobre o processo. Tipicamente, ela exibe telas sinópticas: representações gráficas do processo, com tanques que se enchem, válvulas que mudam de cor e indicadores numéricos que se atualizam em tempo real.
Existe uma norma dedicada ao assunto — a ISA-101, que trata do projeto, da implementação, da operação e da manutenção de interfaces homem-máquina em ambientes industriais. Sua tese central contraria a intuição de muita gente: uma boa IHM não é a mais bonita nem a mais visualmente realista, mas sim a que reduz a carga cognitiva do operador, destacando o que exige atenção imediata e deixando em o segundo plano aquilo que é ruído.
Isso tem consequências de projeto bastante concretas, e várias delas são contraintuitivas:
Cor é um recurso escasso. Cores saturadas devem ser reservadas para condições anormais. Se o processo normal já é verde brilhante, azul e vermelho, não sobra nenhum canal visual para gritar quando algo dá errado. A tela em operação normal deve ser predominantemente cinza e discreta.
Números crus não informam. Um valor de 78 mca não diz ao operador se está bom ou ruim. Um indicador que mostra o valor junto à sua faixa normal, com desvio visível, informa em uma fração do tempo.
Nem tudo merece a tela principal. A ISA-101 organiza a IHM em uma hierarquia de níveis:
o Nível 1 dá a visão geral de toda a operação em uma tela;
o Nível 2 detalha uma unidade;
o Nível 3 detalha um equipamento;
o Nível 4 traz diagnóstico e configuração.
Cada nível responde a uma pergunta diferente, e misturá-los é o que produz aquelas telas entulhadas em que nada se destaca.
O realismo é um inimigo. Desenhos tridimensionais, texturas e gradientes consomem atenção sem carregar informação. A norma prefere representações esquemáticas e planas.
Em situações de emergência, a diferença entre uma tela bem projetada e uma tela entulhada pode ser a diferença entre uma intervenção rápida e um acidente.
Fig. 8 —
Comparação entre telas de supervisório "clássica" e baseada na ISA-101. Referência
Dica
Um teste simples e brutal para avaliar uma IHM: mostre a tela por três segundos a alguém que conhece o processo e pergunte o que precisa de atenção. Se a pessoa não souber responder, a tela falhou — por mais bonita que seja.
Como material complementar, o link a seguir leva a um material de apresentação que introduz a ISA-101.
A ISA-101 é uma normal oficial da ISA (International Society of Automation), cujo link oficial é este, sendo necessário pagamento ou subscrição à ISA para ter acesso ao documento.
Há sites na internet que disponibilizam este conteúdo de forma direta (e.g., pdfcoffe), facilitando assim o acesso ao PDF àqueles que já pagaram a subscrição.
Alarmes
Alarmes são o mecanismo pelo qual o SCADA chama a atenção do operador para condições que fogem do normal. Cada tag pode ser configurada com limites — alto, muito alto, baixo, muito baixo — em relação à faixa de operação normal do processo, e o sistema gera automaticamente um alarme a cada violação, associado a uma prioridade.
A definição formal contém uma exigência que costuma ser esquecida na prática, e que vale enunciar com clareza.
Definição 2·Alarme
Um alarme é um aviso ao operador de que uma condição do processo exige a sua ação, dentro de um prazo determinado.
Os três elementos são igualmente necessários:
Uma condição anormal — o processo saiu da faixa em que deveria estar;
Uma ação disponível — existe algo que o operador pode fazer a respeito;
Um prazo — há uma janela de tempo dentro da qual essa ação precisa acontecer.
Decorre disso a regra mais violada do projeto de alarmes: se não há ação que o operador possa tomar, não é um alarme. É um evento, e o lugar dele é o registro histórico, não a tela de alarmes.
Prioridade
Significado
Ação esperada
Tempo de resposta
Crítico
Risco a pessoas ou equipamentos
Intervenção imediata
Segundos
Alto
Desvio relevante do processo
Ação em curto prazo
Minutos
Aviso
Condição fora do ideal
Monitorar e acompanhar
Horas
A avalanche de alarmes
Na prática, o grande desafio de projeto não é gerar alarmes: é evitar o excesso deles.
É comum que uma variável saia de seus limites operacionais e arraste outras para a mesma situação, gerando a chamada avalanche de alarmes (alarm flooding), em que dezenas ou centenas de alarmes são disparados simultaneamente. No nosso sistema de água, a sequência é fácil de imaginar: a bomba da elevatória 3 para; a pressão no recalque cai e dispara alarme; a vazão cai e dispara alarme; o nível do reservatório começa a baixar e dispara alarme; meia hora depois, a pressão na rede do bairro cai e dispara mais alarmes; o cloro residual sai de faixa e dispara outro. Um único evento físico — a bomba parou — produziu oito alarmes em cascata, e o operador precisa adivinhar qual deles é a causa.
Essa situação é capaz de paralisar um operador, especialmente um menos experiente, justamente no momento mais crítico. É uma das principais causas de erro operacional identificadas em investigações de incidentes industriais.
Como se evita: da técnica ao ciclo de vida
O combate à avalanche opera em dois planos. No plano técnico, há um conjunto de mecanismos bem estabelecidos.
A banda morta (deadband) exige que a variável retorne além do limite por uma margem antes que o alarme seja considerado normalizado, eliminando a repetição de uma variável que oscila em torno do seu limite — a causa mais comum de alarmes repetidos.
O atraso de ativação (on-delay) exige que a condição persista por um tempo mínimo antes de gerar o alarme, filtrando transientes que se resolvem sozinhos.
A supressão por dependência (ou por estado) inibe alarmes que são consequência previsível de outro. Se a bomba está reconhecidamente parada, o alarme de pressão baixa no seu recalque não acrescenta informação alguma e deve ser suprimido. Essa é a técnica que resolve a cascata do nosso exemplo, reduzindo-a de oito alarmes a um.
A priorização criteriosa completa o conjunto. Uma heurística amplamente usada é que alarmes críticos não devem passar de 5% do total, e alarmes de prioridade alta, de 15% — se tudo é crítico, nada é.
No plano organizacional, a norma ISA-18.2 trata a gestão de alarmes como um ciclo de vida completo: filosofia, identificação, racionalização, projeto, implementação, operação, manutenção, monitoramento e gestão de mudanças. A ideia central é que alarmes não são configurados uma vez e esquecidos — eles precisam ser racionalizados, isto é, cada alarme deve ser justificado individualmente contra a definição que vimos: há condição anormal, há ação possível, há prazo? Alarmes que não passam nesse teste são reclassificados como eventos.
A norma também estabelece métricas de desempenho que permitem avaliar objetivamente um sistema de alarmes em operação: o alvo é de até 150 alarmes por operador por dia, com no máximo 10 por hora em regime e nunca mais de 10 nos 10 minutos seguintes a um distúrbio. Sistemas reais não racionalizados costumam operar uma ordem de grandeza acima disso.
Atenção
Um sistema que dispara centenas de alarmes por minuto é, na prática, um sistema sem alarmes: o operador não consegue distinguir o crítico do irrelevante e acaba ignorando todos. A avalanche de alarmes é uma das principais causas de erro operacional em incidentes industriais.
Exemplo 20·Racionalizando a cascata da elevatória
O sistema de água descrito acima dispara, quando a bomba da EEB-03 para inesperadamente, a seguinte sequência de alarmes:
t
Tag
Condição
Prioridade atual
0 s
EEB_03_BOMBA_A_STAT
Bomba parada sem comando
Crítico
4 s
EEB_03_PRES_REC
Pressão baixa
Crítico
12 s
EEB_03_VAZAO
Vazão baixa
Crítico
15 s
EEB_03_BOMBA_A_CORR
Corrente zero
Alto
20 min
RSV_CENTRO_NIVEL
Nível baixo
Alto
38 min
RED_CENTRO_PRES
Pressão na rede baixa
Crítico
Adicionalmente, entre 4 s e 9 min, a tag EEB_03_PRES_REC oscila em torno do limite e gera 22 alarmes repetidos.
Proponha uma racionalização: o que vira evento, o que é suprimido, o que permanece e com qual prioridade. Justifique cada decisão pela definição de alarme.
Para cada linha, faça as três perguntas da definição: há condição anormal, há uma ação que o operador possa tomar que já não decorra do primeiro alarme, e há prazo? Depois trate separadamente o problema das 22 repetições, que é de natureza diferente.
As 22 repetições são o problema mais simples e o mais grave em volume. Elas não são alarmes distintos: são a mesma condição oscilando em torno do limite. Aplica-se deadband (por exemplo, normalizar apenas acima de 5 mca do limite) combinado com on-delay de alguns segundos. Isso elimina 22 dos 28 avisos, sem perder informação alguma.
EEB_03_BOMBA_A_STAT (t = 0 s) — permanece, como crítico. É a causa raiz, há ação clara (partir a bomba reserva ou despachar equipe) e o prazo é curto. É o único alarme que o operador precisa ver imediatamente.
EEB_03_PRES_REC e EEB_03_VAZAO — suprimidos por dependência enquanto a bomba estiver reconhecidamente parada. São consequência determinística do evento raiz e não habilitam nenhuma ação adicional. Continuam registrados como eventos no historian, para a investigação posterior.
EEB_03_BOMBA_A_CORR (corrente zero) — vira evento, não alarme. É redundante com o estado da bomba e não acrescenta decisão. Seu valor está na análise posterior: a curva de corrente antes da parada é o que diz se foi falha elétrica ou travamento mecânico.
RSV_CENTRO_NIVEL (t = 20 min) — permanece, mas reclassificado como alto e, idealmente, antecipado. Aqui a ação é diferente da anterior: se a bomba não voltou em 20 minutos, é hora de acionar a manobra de rede ou avisar a operação. Melhor ainda seria substituí-lo por um alarme preditivo baseado na taxa de queda do nível — "esvaziamento em 35 min no ritmo atual" —, que dá ao operador tempo de agir em vez de informá-lo quando já é tarde.
RED_CENTRO_PRES (t = 38 min) — deve ser rebaixado de crítico para alto, ou suprimido por dependência do nível baixo. Quando ele dispara, o desabastecimento já está acontecendo: ele não habilita ação preventiva alguma, apenas confirma a falha.
Resultado: de 28 avisos em 38 minutos para 2 alarmes acionáveis (a parada da bomba e o risco de esvaziamento), com todo o restante preservado como eventos no histórico. O operador vê a causa, não a consequência.
Software SCADA na prática
Tudo o que foi descrito até aqui (servidor de tags, motor de alarmes, historian, editor de telas, drivers de protocolo) chega ao engenheiro na forma de um produto de software.
É possível que o engenheiro implemente uma stack própria de automação SCADA, implantando banco de dados, escrevendo algoritmos para a automação de alarmes, criando telas de supervisão e integrando tudo (e.g., usando o Node-RED).
Especificamente para sistemas SCADA porém, existem diversos softwares comerciais e open-source dedicados que já oferecem em um só pacote as funcionalidades esperadas para estes tipos de sistema.
Vale conhecer o panorama, ainda que superficialmente, porque a arquitetura conceitual estudada no módulo aparece de forma bastante reconhecível em todos eles.
No mercado brasileiro, a Elipse Software, empresa de Porto Alegre, é uma referência consolidada: o Elipse E3 é largamente empregado em saneamento e energia no país, e o Elipse Power atende especificamente o setor elétrico. Entre as plataformas internacionais, o Ignition (Inductive Automation) ganhou espaço rápido com um modelo de licenciamento por servidor em vez de por tag e uma arquitetura fortemente baseada em web; o WinCC (Siemens) domina os ambientes que já usam PLCs do mesmo fabricante; e o zenon (COPA-DATA) tem presença forte em energia e automotivo na Europa. No mundo do software livre há opções como o ScadaBR, de origem brasileira e bastante usado em ensino, Rapid SCADA, o Fuxa SCADA.
Ao avaliar qualquer um deles, o modelo de licenciamento merece atenção especial, porque é frequentemente o fator dominante no custo total. Licenças cobradas por tag tornam caro monitorar mais pontos (e criam um incentivo perverso a instrumentar menos do que seria tecnicamente adequado).
Licenças por servidor ou por cliente têm outra dinâmica.
Há também as aplicações que são gratuítas para uso.
Vale também verificar quais drivers de protocolo estão inclusos e quais são cobrados à parte (pois estes definirão a capacidade do software SCADA operar de fato com os instrumentos e equipamentos da planta.)
Gerações de arquitetura SCADA
A arquitetura dos sistemas SCADA evoluiu em gerações sucessivas, e cada uma delas resolveu uma limitação da anterior ao custo de introduzir um risco novo.
Os primeiros SCADA eram monolíticos: a MTU era um único computador central, isolado, que fazia tudo. A comunicação era proprietária e ponto a ponto. A vantagem era o isolamento natural; a desvantagem, a ausência total de redundância e escalabilidade.
A segunda geração, distribuída, dividiu funções entre várias estações conectadas por redes locais, geralmente ainda proprietárias. Ganhou-se redundância e escala dentro do site.
A terceira geração, em rede, adotou protocolos de TI padrão — sobretudo TCP/IP — e passou a usar a infraestrutura das redes corporativas. Ganhou-se interoperabilidade, custo e facilidade de integração, e perdeu-se o isolamento que protegia as duas gerações anteriores.
A geração atual incorpora IoT, computação em nuvem e edge computing, levando dados de campo diretamente a plataformas analíticas. Ganhou-se análise em escala e manutenção preditiva, e ampliou-se novamente a superfície de ataque.
O padrão é claro: cada geração ampliou as capacidades e, junto com elas, a exposição.
Nota
Na prática, é comum encontrar sistemas industriais rodando gerações antigas, ou mesclando gerações diferentes no mesmo sistema — uma RTU serial dos anos 1990 conversando, através de um conversor, com uma plataforma em nuvem. Essas junções improvisadas costumam ser os pontos mais frágeis da arquitetura.
Convergência IT/OT
A grande tendência atual é a convergência entre TI (Tecnologia da Informação, o mundo corporativo de dados) e OT (Tecnologia de Operação, o mundo do chão de fábrica).
Conectar os dois traz benefícios reais e mensuráveis: dados de processo alimentam análises de negócio, manutenção preditiva e otimização energética. No nosso sistema de água, a convergência é o que permite cruzar o histórico de vazão com o faturamento para estimar perdas na rede (uma informação de enorme valor econômico que nenhum dos dois mundos produz sozinho).
Mas essa mesma ponte conecta os sistemas OT (muitos deles antigos e inseguros por projeto) às redes corporativas e, indiretamente, à internet.
A convergência IT/OT é, ao mesmo tempo, a maior oportunidade de evolução tecnológica e o maior risco de segurança dos sistemas SCADA modernos.
Segurança em ambientes SCADA/OT
Os sistemas SCADA controlam processos e infraestruturas do mundo real dos quais dependem muitas pessoas: água, energia, transporte, saneamento. Um comprometimento não significa apenas vazamento de dados — significa dano físico potencial.
Durante décadas, a segurança desses sistemas apoiou-se em três premissas que hoje são frágeis:
a obscuridade dos protocolos proprietários;
o isolamento físico das redes;
e a confiança implícita em qualquer dispositivo dentro da rede interna.
A convergência IT/OT derrubou as três. O setor industrial enfrenta agora uma escolha difícil: investir para adaptar-se, ou permanecer com tecnologias legadas e inseguras operando infraestrutura crítica.
Atualmente, as principais referências para a concepção e implementação de redes industriais seguras são as normas IEC 62443 e a NIST SP 800-82.
Modelo Purdue e o mito do air gap
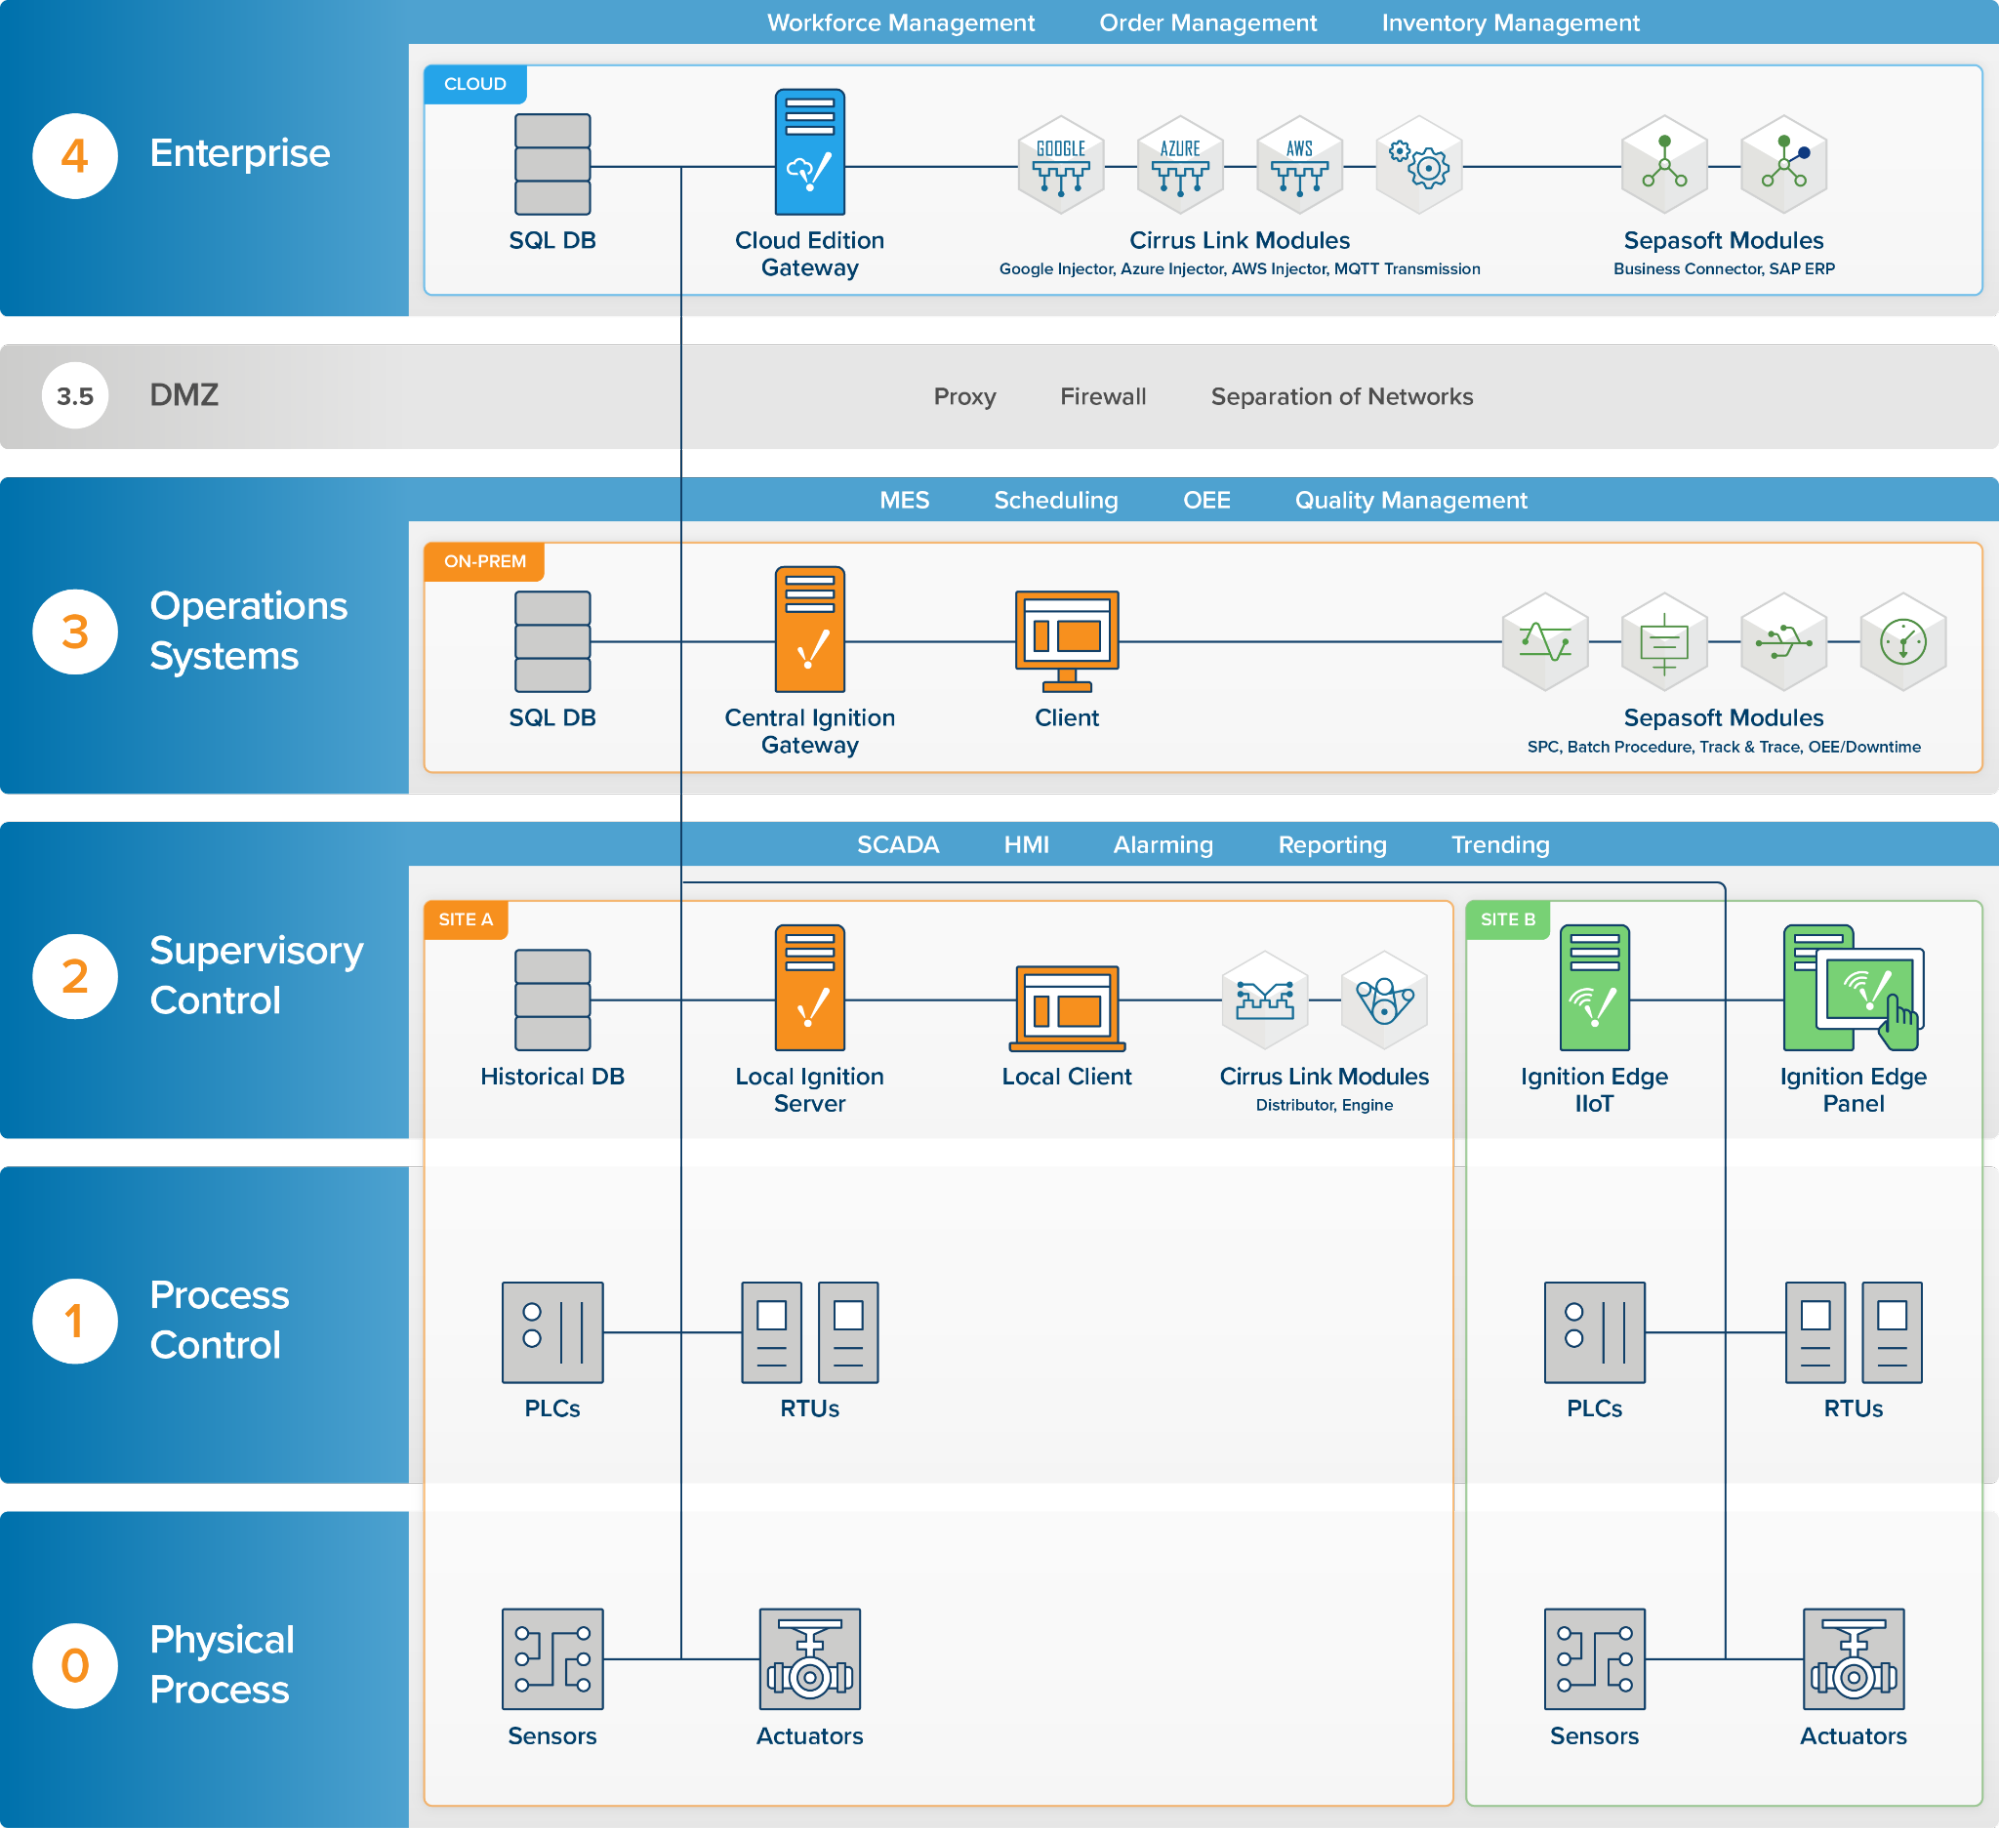
O Modelo Purdue é a referência clássica para estruturar redes industriais em níveis hierárquicos — e é a pirâmide da automação da Aula 1 relida como arquitetura de rede. Vai do chão de fábrica (níveis 0 e 1) à supervisão (nível 2), passando pela operação do site (nível 3) até a rede corporativa (níveis 4 e 5), com uma DMZ industrial na fronteira entre OT e TI. A ideia central é que o tráfego entre níveis seja explícito, controlado e auditável, em vez de livre.
Por muito tempo, confiou-se também no chamado air gap — a ideia de que a rede OT estaria fisicamente isolada de qualquer outra e, portanto, inalcançável. Na prática, esse isolamento quase nunca é total. Pen drives usados para transferir configurações, laptops de manutenção que circulam entre a rede corporativa e a planta, modems celulares instalados por fornecedores para suporte remoto, conexões temporárias que nunca são removidas e a própria convergência IT/OT abrem brechas. Hoje, tratar o air gap como garantia de segurança é perigoso — e, como veremos adiante, o caso mais famoso da história da segurança industrial foi precisamente a demonstração disso.
Fig. 9 —
Ilustração de exemplo da implementação do Modelo Purdue em uma rede industrial/empresarial. Referência
Por que a segurança de TI não se aplica direto
Profissionais habituados à TI frequentemente se equivocam ao transplantar suas práticas para OT sem adaptação. Três diferenças estruturais explicam por quê.
A primeira é a inversão de prioridades. Na TI clássica, a tríade prioriza a confidencialidade: o pior desfecho é o vazamento. Em OT, a disponibilidade vem primeiro — um processo industrial não pode simplesmente "cair" para aplicar uma atualização, e uma parada não programada de uma estação de tratamento deixa uma cidade sem água.
A segunda é o ciclo de vida. Equipamentos de OT operam por décadas. É absolutamente rotineiro encontrar em produção uma estação de supervisão rodando um sistema operacional sem suporte há anos, impossível de atualizar sem parar a produção e, muitas vezes, sem validação do fabricante para qualquer alteração.
A terceira é o impacto. Uma falha em TI tem consequências digitais e financeiras; uma falha em OT pode ter consequências físicas — equipamento destruído, produto contaminado, pessoas feridas.
Segurança em OT é, portanto, uma disciplina própria, e não um recorte da segurança de TI.
Prioridade
TI clássica (CIA)
OT / SCADA (AIC)
1ª
Confidencialidade
Disponibilidade
2ª
Integridade
Integridade
3ª
Disponibilidade
Confidencialidade
Perigo
Aplicar políticas agressivas de patching de TI em um ambiente OT pode causar paradas não planejadas em processos críticos. Atualizações em OT exigem janelas de manutenção acordadas, testes prévios em bancada e, com frequência, validação formal do fabricante.
Estudos de caso: Stuxnet e a rede ucraniana
Dois incidentes ajudam a entender por que a segurança SCADA deixou de ser tema acadêmico.
O Stuxnet, descoberto em 2010, foi um malware de sofisticação sem precedentes que atacou centrífugas de enriquecimento de urânio no Irã. Ele se propagou por pen drives até alcançar uma rede supostamente isolada, identificou uma configuração muito específica de PLCs Siemens e passou a manipular a frequência dos acionamentos, levando as centrífugas à destruição mecânica por fadiga. O detalhe mais instrutivo do ataque é o que ele fazia em paralelo: gravava as leituras normais do processo e as reproduzia para os operadores enquanto o dano acontecia. As telas mostravam tudo normal. É a demonstração definitiva de duas lições — de que o air gap não é garantia, e de que a IHM só é confiável na medida em que a cadeia de dados por trás dela for.
Os ataques à rede elétrica da Ucrânia, a partir de dezembro de 2015, seguiram um caminho diferente e mais reproduzível. Os atacantes obtiveram credenciais legítimas por phishing na rede corporativa, moveram-se lateralmente até a rede OT ao longo de meses e, no dia escolhido, usaram as próprias ferramentas de operação do SCADA para abrir disjuntores remotamente, deixando centenas de milhares de pessoas sem energia. Simultaneamente, derrubaram a central de atendimento telefônico e inutilizaram firmwares de conversores seriais, para atrasar o restabelecimento. Nenhum malware exótico foi necessário: o sistema fez exatamente aquilo para o que foi projetado, comandado por quem não deveria.
Juntos, esses casos mudaram a percepção de risco do setor inteiro. O primeiro mostrou que o isolamento não protege; o segundo, que nem sequer é preciso quebrar nada — basta entrar.
Atenção
Repare na diferença de método entre os dois casos. O Stuxnet precisou de um arsenal de vulnerabilidades inéditas; o ataque ucraniano precisou apenas de uma senha e de paciência. O segundo modelo é incomparavelmente mais fácil de reproduzir — e é por isso que ele preocupa mais.
Princípios de defesa
Não existe bala de prata em segurança cibernética, mas há princípios sólidos e bem estabelecidos.
A segmentação de rede, estruturada segundo o Modelo Purdue e com uma DMZ industrial bem definida, limita o movimento lateral de um atacante que já entrou — que é, como vimos no caso ucraniano, o cenário realista.
O monitoramento passivo do tráfego OT, feito por ferramentas que entendem protocolos industriais, dá visibilidade sobre o que está acontecendo na rede e detecta comandos fora do padrão sem interferir no processo. É especialmente valioso em OT justamente porque não injeta tráfego: varreduras ativas de vulnerabilidade, rotineiras em TI, podem derrubar dispositivos de campo antigos.
O controle rigoroso de acesso, físico e lógico, com autenticação forte e privilégio mínimo, restringe quem pode tocar o quê. Vale lembrar que, nos dois estudos de caso, o vetor inicial foi humano.
A defesa em profundidade, com múltiplas camadas independentes, garante que a falha de uma proteção não comprometa o sistema inteiro.
E, transversal a tudo, a capacidade de detectar e responder: registro centralizado, plano de resposta a incidentes escrito e ensaiado, e backups de configuração de RTUs e PLCs testados — porque restaurar uma planta a partir de um backup que nunca foi verificado é descobrir o problema na pior hora possível.
O objetivo não é tornar o ataque impossível, o que é utopia, mas torná-lo caro e detectável.
Exemplo 21·Onde este sistema quebraria?
Retome o sistema de abastecimento de água que acompanhou todo o módulo: RTUs nos reservatórios ligadas por rádio, elevatórias ligadas por 4G, MTU redundante na sede, Modbus TCP em todo o campo, e uma integração com o ERP para faturamento. O fornecedor do SCADA mantém um modem 4G na sala de servidores para suporte remoto.
Identifique três fragilidades de segurança nessa arquitetura e proponha uma mitigação para cada uma, apoiando-se nos princípios vistos.
Percorra a arquitetura procurando: (i) onde há confiança implícita, (ii) onde o air gap é ilusório e (iii) quais limitações do Modbus, estudadas na seção de protocolos, se tornam vulnerabilidades quando o canal é acessível.
Há mais de três, mas estas são as mais graves:
1. O modem 4G do fornecedor. É um caminho de entrada direto para a rede OT, fora de qualquer controle da concessionária, e reproduz exatamente o vetor de acesso inicial do caso ucraniano. Mitigação: eliminar o acesso permanente. O suporte remoto deve passar pela DMZ industrial, com acesso concedido por solicitação, autenticação forte, janela de tempo limitada e sessão gravada.
2. Modbus TCP em todo o campo. Sem autenticação nem criptografia, qualquer um com acesso ao canal pode escrever registradores — isto é, comandar bombas e válvulas. O enlace 4G agrava o quadro, pois o tráfego atravessa infraestrutura de terceiros. Mitigação: de imediato, encapsular o tráfego em VPN com autenticação mútua entre campo e central, de modo que o canal deixe de ser acessível a quem não tem a chave; no médio prazo, migrar para DNP3 com Secure Authentication ou OPC-UA nos equipamentos que suportem.
3. A integração com o ERP. É a ponte IT/OT do sistema, e a pergunta decisiva é qual o sentido do fluxo. Se o ERP alcança diretamente o servidor de tags, um comprometimento da rede corporativa — o alvo mais fácil e mais atacado — chega ao campo. Mitigação: inverter o fluxo. Nada da rede corporativa deve iniciar conexão para dentro do OT; o SCADA publica dados em um servidor na DMZ industrial e o ERP lê de lá. Aplicar a mesma disciplina de segmentação do Modelo Purdue.
Menções honrosas. As RTUs provavelmente operam com senhas padrão de fábrica e firmware nunca atualizado; não há registro centralizado que permitiria detectar um comando anômalo; e é bem provável que não exista backup testado das configurações das RTUs — o que, num incidente, transforma uma restauração de horas em uma reconstrução de semanas.
Conclusão
Percorremos o módulo seguindo um único dado: a leitura de nível de um reservatório em uma cidade de 120 mil habitantes.
Vimos esse dado nascer no campo, num sensor lido por uma RTU que continua operando mesmo quando o rádio cai. Vimos ele ganhar identidade ao se tornar uma tag, com nome, unidade, qualidade e carimbo de tempo — e vimos que, sem esses dois últimos atributos, ele mente. Vimos ele viajar até a central, por polling ou por exceção, dentro de um ciclo de scan cujo dimensionamento é uma conta de engenharia entre a dinâmica do processo e a capacidade do canal. Vimos ele chegar ao operador através de uma IHM cujo mérito se mede pela carga cognitiva que ela poupa, e de um sistema de alarmes cujo desafio é calar mais do que falar. Vimos ele atravessar protocolos projetados em épocas diferentes, com premissas diferentes sobre banda e sobre confiança. E vimos que esse mesmo caminho, percorrido em sentido contrário por quem não deveria, é o que transforma um sistema de supervisão em um vetor de dano físico.
A mensagem central é que o SCADA é a costura entre o mundo físico e o digital — e que cada decisão de projeto ao longo desse caminho, do nome de uma tag à segmentação da rede, afeta diretamente a operação e a segurança do conjunto.
Dica
O módulo em uma frase: o SCADA supervisiona e registra processos físicos dispersos, organizando tudo em tags, comunicando-se por protocolos industriais e exigindo uma postura de segurança própria do mundo OT.